Data-extractie: van ongestructureerde rommel naar rijen die blijven staan
AI is sterk in ongestructureerde data omzetten naar structuur. Extractie en vastleggen is vaak stap één. Daarna kun je verder bouwen. Pricingscanner: 40.000+ producten vergelijkbaar.
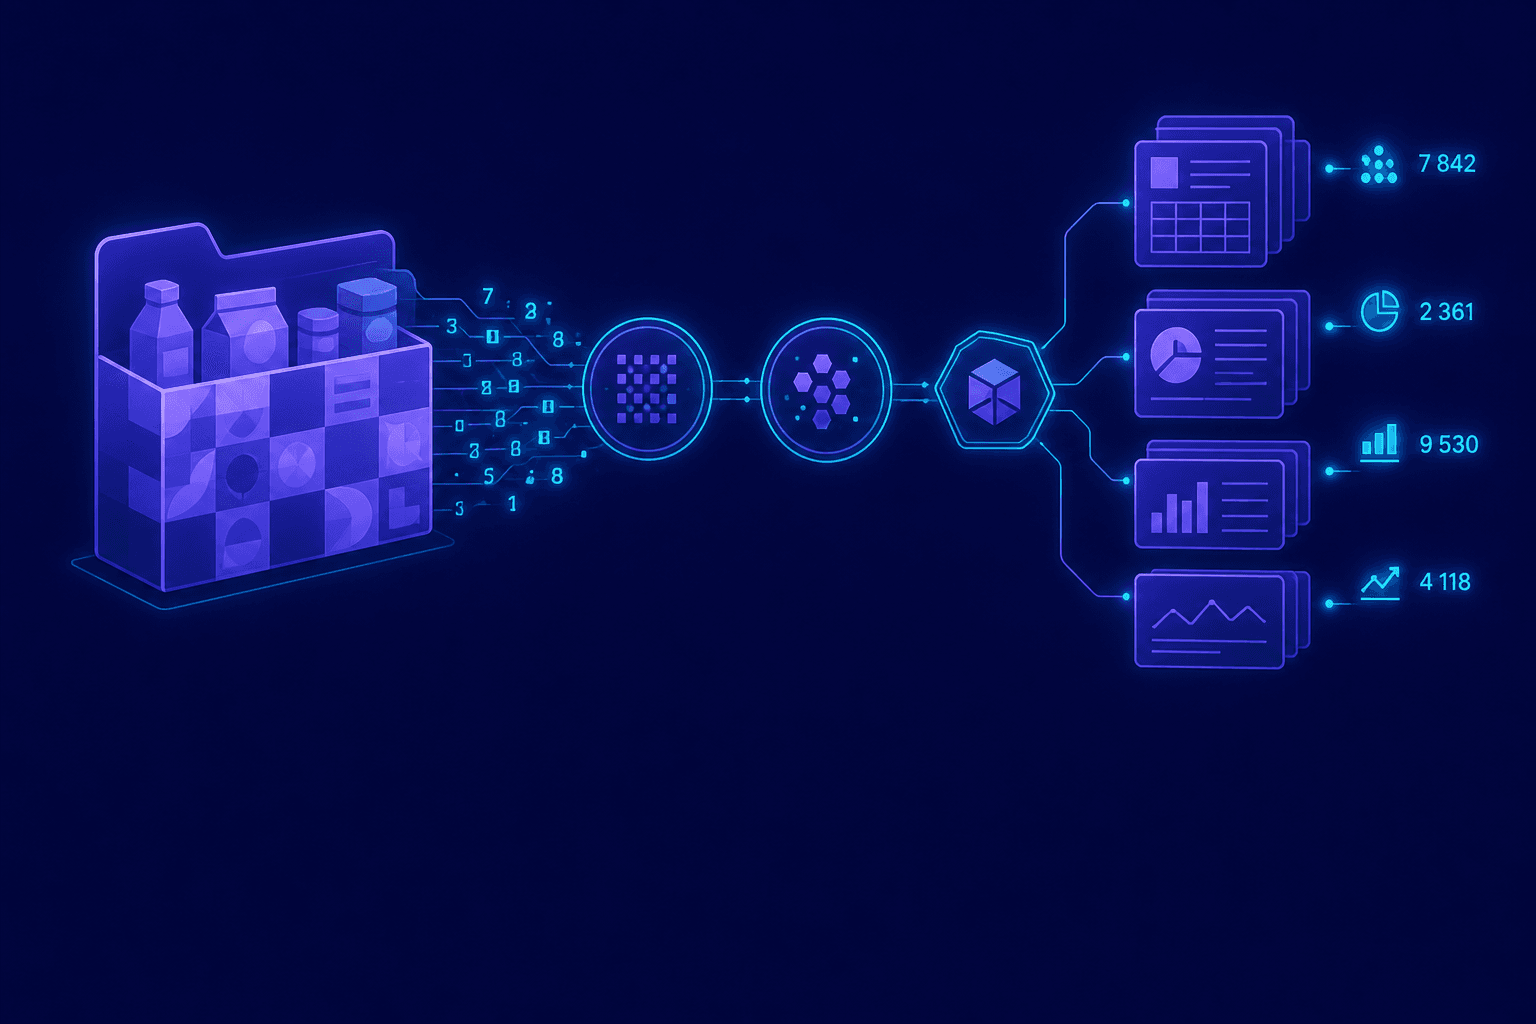
AI is bijzonder goed in één ding: ongestructureerde data omzetten naar gestructureerde data. De wereld zit vol mails, facturen, offertes, folders, pdf's, interne stukken, papier, video, audio, zelfs Excel. Computers, databases en code willen rijen. Extractie plus vastleggen is daarom vaak stap één. Niet het product. De voorwaarde.
De wereld is flexibel. Systemen zijn dat niet.
Je kunt een proces in code vastleggen. Dan moet de input voorspelbaar zijn: velden, types, dezelfde betekenis morgen als gisteren. De realiteit werkt zo niet. Een folder ziet er elke week anders uit. Een mail heeft geen schema. Een Excel van de afdeling is voor mensen een tabel en voor een pipeline rommel: andere kolommen, andere eenheden, andere namen voor hetzelfde product.
Dat gat is het probleem. Niet "we hebben te weinig AI". Je hebt te veel waarde vastzitten in vormen die je systeem niet lust.
Daar is AI sterk. Het kan die rommel innemen en iets uitspugen dat in een database mag. Dat is een fundamenteel principe. Pricingscanner staat erop. Beste.nl ook: folders die geen rijen waren, wel rijen maken. Zelfde brug, andere keten.
Extractie is de makkelijke helft
Een parser of een chat die "haal de velden eruit" zegt, stopt bij JSON of een sheet. Bruikbaar is dat nog niet.
Bruikbaar betekent: één format, ook als de bronnen niet op elkaar lijken. Hetzelfde product over bronnen heen is hetzelfde product. Allergenen komen uit een ingrediëntenlijst, niet uit een apart handmatig veld. Het blijft binnenkomen. Geen eenmalige dump die volgende week alweer achterloopt.
Matching is daar het onzichtbare werk. Dezelfde yoghurt, andere spelling, andere verpakking, 500 ml in de ene bron en 0,5 l in de andere. Voor een mens is dat één product. Voor een dump zijn het drie rijen. Tot je eenheden, namen en bronnen tot elkaar dwingt, kun je niet vergelijken en dus niet verder bouwen.
Verrijking komt ná die rijen. Als de ingrediënten eruit zijn, kun je allergenen afleiden. Als de naam eruit is, kun je een beschrijving maken. Dat is geen extra chat op de folder. Dat is een tweede stap op data die al mag bestaan.
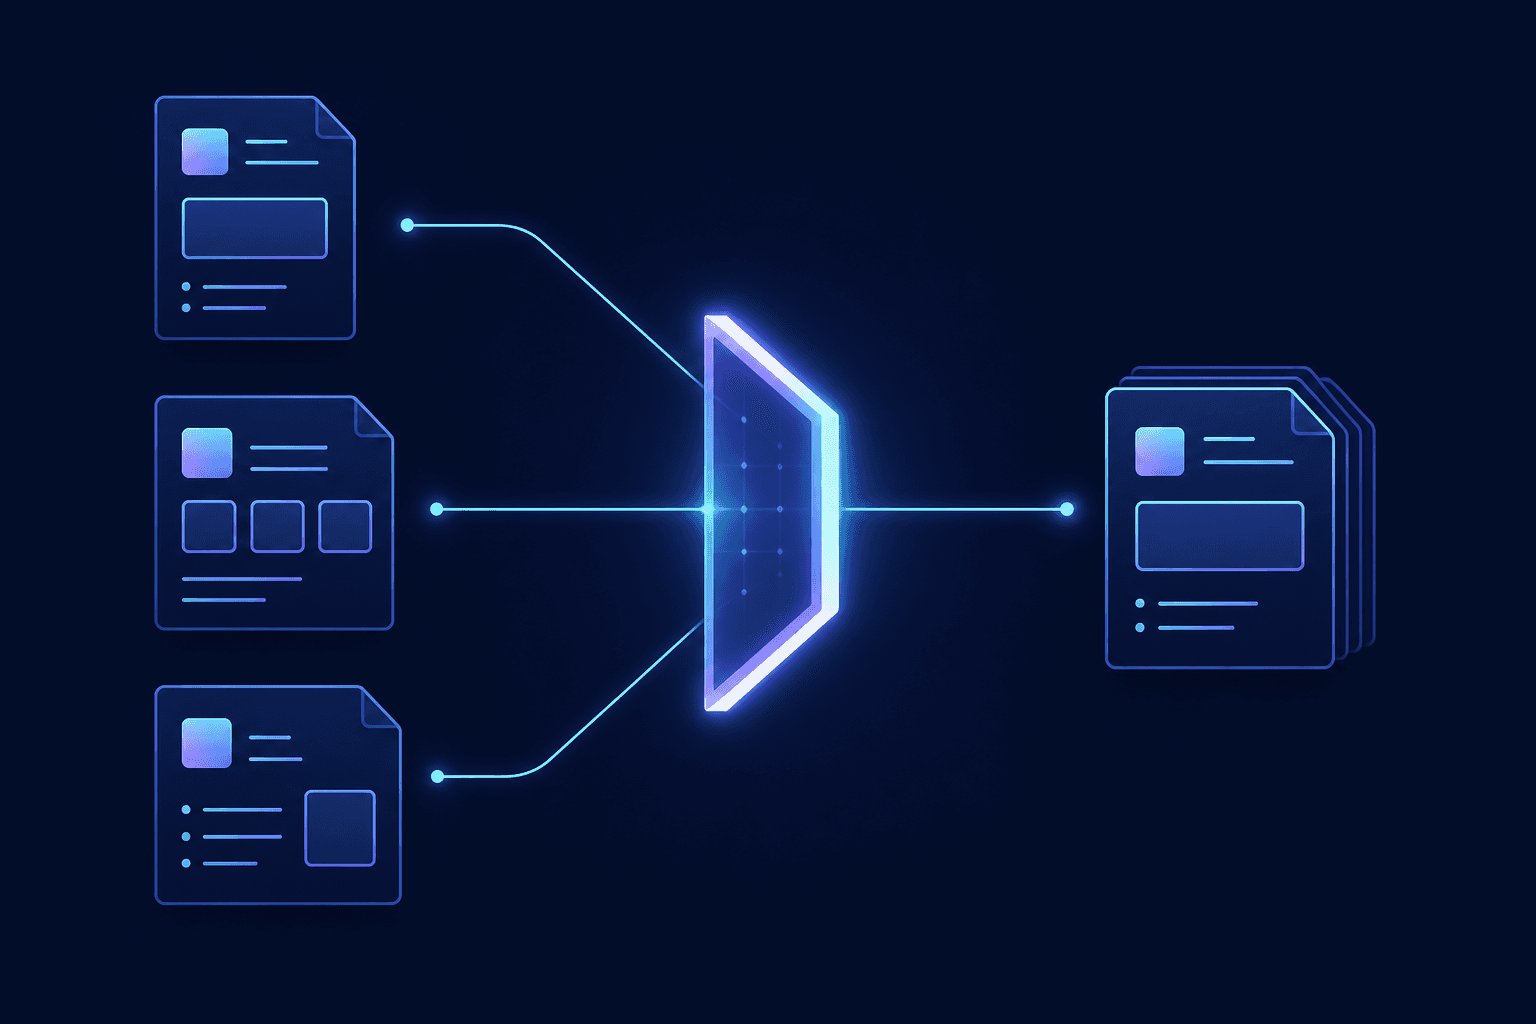
Dat werk heet matching, normalisatie, verrijking. Het model doet de sprong van tekst en beeld naar velden. Het bouwwerk is wat je daarna afdwingt, en dat het blijft lopen.
Daarom geen modelnamen of ranglijstjes. Modelkwaliteit telt aan de rafelrand: handschrift, scheve scans, rare folders. Het is niet de architectuur.
Pricingscanner: eerst vastleggen, dan bouwen
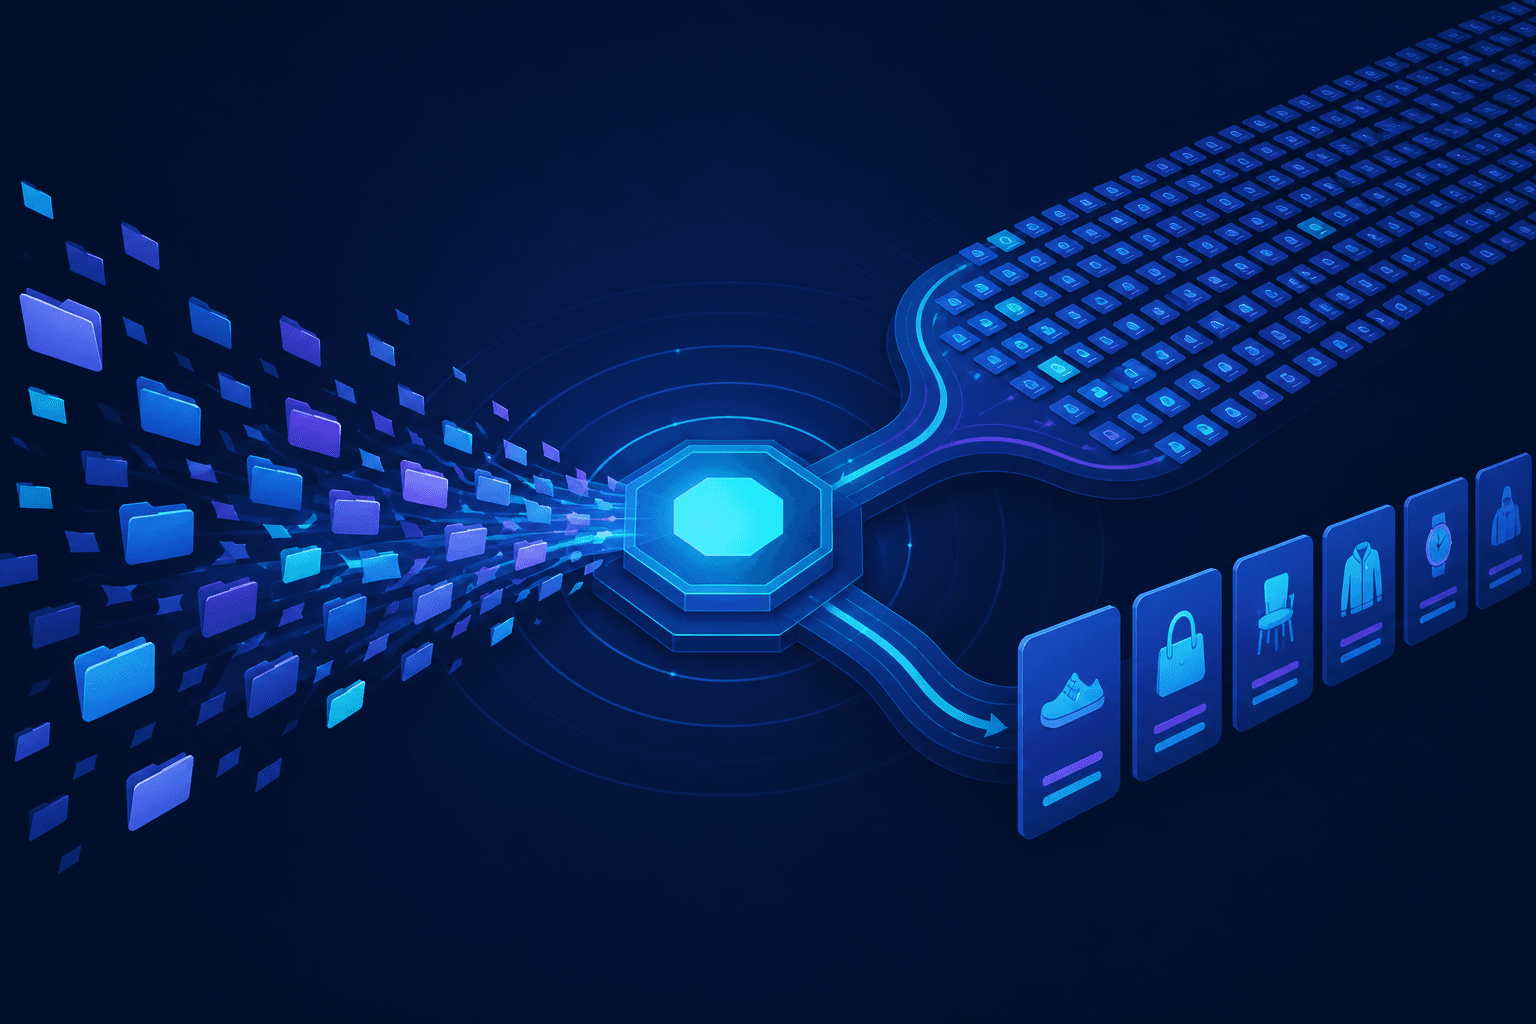
Bij Pricingscanner komt product- en prijsinformatie binnen in allerlei vormen. De pipeline extraheert, brengt alles naar één format, en verrijkt: allergenen, beschrijvingen, vergelijkbaarheid. Matching maakt producten over bronnen heen vergelijkbaar.
Waarom een chat dit niet houdt: je plakt één pagina, je krijgt velden, klaar. Volgende week is er weer een berg. 40.000+ producten is geen prompt. Het is een keten die blijft eten, structuren, en hetzelfde product herkent als hetzelfde product. Mensen houden dat volume niet vol. Een losse chat ook niet.
Resultaat: 40.000+ producten gedigitaliseerd en vergelijkbaar. Live op pricingscanner.com. De datalaag voedt daarna verder werk. Content en analyse staan op die rijen, niet op de oorspronkelijke rommel.
Pas toen die laag stond, kon de volgende keten. Recepten op echte productdata, in een vaste lijn. Dat is de les, niet de bijlage. De contentketen staat in maatwerk software met AI in het proces. Hier telt de volgorde: zonder vastgelegde data geen keten erachter.
Als je met AI wilt werken, moet er iets liggen. Extractie is hoe je dat liggen krijgt als het nog in de wereld zit: in pdf's, folders, mail, scans, een spreadsheet die iedereen anders invult. Daarna kun je het in een database zetten en eromheen bouwen. Daarvoor is het giswerk op documenten.
Zelfde patroon, andere rommel
Papier is het extreme geval. Jaren formulieren, ergens in een kast. Waardevol, niet in een systeem. Mensen krijgen er hoofdpijn van. Dat is nu te digitaliseren, en dan kun je eromheen bouwen. Als er nóg niks is om uit te lezen (geen tekst, geen scan, geen spoor), is de eerste beweging niet "een model erop". Dan is het vastleggen, koppelen, bewaren. Daarna de AI-brug.
Matching is hetzelfde principe in de andere richting. Twee ongestructureerde dingen, bijvoorbeeld een aanbesteding en een bedrijfsprofiel, naar een harde score. Een rubriek, zoals je werk beoordeelt, tot een totaal. Gevoelige persoonsdata hoort daar alleen in als je die eerst buiten de keten houdt. Het punt is de brug, niet een HR-product.
Die voorbeelden zijn geen extra diensten. Het is één beweging: rommel in, rijen uit, dan pas de rest.
Wat we niet doen
Geen lijst "beste IDP". Geen Exact eruit trekken. Geen belofte dat één model je berg alleen opruimt. We bouwen de keten naast de lead, op wat jullie al hebben, tot de rijen in een database staan en het team erop kan werken.
De korte versie staat op data-extractie. Hier: waarom stap één bestaat, en wat "klaar" betekent als het geen export is maar een keten.
Wat jij nu kunt doen
Kijk naar één berg die geen rijen is. Folders, pdf's, mail, papier, een Excel die iedereen anders invult. Als die berg in een database zat, welk werk wordt dan ineens mogelijk? Een matching. Een verrijking. Iets dat nu blijft liggen omdat de input te rommelig is.
Dat is het gesprek. Geen toolkeuze eerst. Wat moet eruit, in welk schema, en waar blijft het staan.
Een proces dat te duur of te traag is?
We kijken samen of maatwerksoftware, met of zonder AI, dat in de operatie kan zetten.
Plan een gesprek